이번 토스 면접에서 kafka에 대해서 질문을 줬지만 난 대답하지 못했다.

왜? 잘 모르니까..

그냥 얼레벌레 써봤지.. 뭘 제대로 알았겠어..

그래서 후회돼서 복기해본다..


Kafka에 대한 큰 흐름

  • 토픽(topic)은 물리적인 메시지 스트림이고, 물리적으로는 여러 개의 파티션(partition)으로 쪼개진다고 한다.
  • 파티션은 추가만 되는 순서 있는 로그라고 보면되고 메시지마다 오프셋(offset)이라는 단조 증가 번호가 붙는다.
  • 순서 보장은 "파티션 안에서만" 되고, 토픽 전체로는 순서를 보장하지 않는다.
  • "같은 키는 같은 파티션으로 보낸다"가 중요한 포인트
  • 프로듀서는 메시지 키가 있으면 hash(key) % 파티션 수로 파티션을 고르고, 키가 없으면 스티키 파티셔너로 분리한다.
    • 즉, 순서가 중요한 단위 (예: 같은 주문 ID, 같은 판매자 ID)는 키로 묶어야 그 단위 안에서 순서가 지켜진다.
  • 복제 (Replication) : 각 파티션은 리더 1개 + 팔로워 N개로 복제된다. 읽기/쓰기는 리더가 처리하고 팔로워가 따라 온다. 따라잡고 있는 복제본 집합을 ISR(In-Sync Replicas)라고 한다.

토픽이란?

  • 메시지를 종류별로 담는 이름표
  • 메시지를 보내는 쪽(프로듀서)는 "이 메시지를 어느 토픽에 적을까?"를 정하구, 받는 쪽(컨슈머)는 "나는 어느 토픽을 읽을까?"를 정한다.
  • 주문 토픽을 구독한 컨슈머는 주문 메시지만 받지, 결제 메시지는 받지 않는다.
  • 종류가 섞이지 않게 칸막이를 쳐주는 게 토픽의 역할
  • 토픽은 이름일 뿐, 실제 데이터가 저장되는 물리적인 통이 아니다.

파티션이란?

  • 토픽이 이름이었다면? 파티션은 실제로 메시지가 줄줄이 쌓이는 진짜 통!
  • orders 토픽을 파티션 3개로 만들면 주문이 들어올 때마다 셋 중 하나의 파티션에 가서 맨 뒤에 한 줄씩 추가된다.
  • 글을 적을 때 항상 맨 아래 빈 줄에 이어 쓰는 것과 같다. 중간에 끼워넣거나 지우지 않고, 무조건 뒤에만 붙인다.
    • 추가만 되는 로그

브로커(broker)란?

  • 그 통들이 실제로 올라가 있는 컴퓨터(서버)가 브로커.
  • 당시 운영 카프카는 브로커 3대 클러스터
  • replication factor(복제 계수) : 복사본을 총 몇 개로 유지할지 정하는 숫자
    • 원본 포함 전체 개수
    • replication factor = 1 → 원본 하나뿐, 복사본 없음 (그 브로커 죽으면 데이터 날아감)
    • replication factor = 2 → 원본 1 + 복사본 1 = 총 2벌
    • replication factor = 3 → 원본 1 + 복사본 2 = 총 3벌
  • In-Sync Replicas (ISR) - "잘 따라오고 있는 복사본"
    • 복사본(팔로워)이 3벌 있다고 해서, 그게 항상 원본이랑 똑같다는 보장은 없다.
    • 네트워크가 느리거나 한 브로커가 버벅대면, 어떤 팔로워는 리더가 받은 최신 메시지를 아직 못 베낀 채 뒤처질 수 있다.
    • In-Sync (싱크 맞음) : 리더를 거의 실시간으로 따라잡고 있는 복사본
    • Out-of-Sync (뒤처짐) : 너무 늦어서 신뢰할 수 없는 복사본
    • 리더가 죽었을 때, 새 리더는 반드시 ISR 안에 있는 복사본 중에서만 뽑기 때문에 ISR은 중요하다.


파티션이 카프카의 거의 전부인 이유?

  • 병렬 처리
    • 통이 3개니까, 컨슈머 3명이 각자 하나씩 동시에 읽을 수 있다.
    • 처리 속도를 올리고 싶으면 파티션을 늘린다
    • 컨슈머를 몇 개 띄울지는 개발자가 정해서 직접 실행한다.
    • 보통 애플리케이션(서버) 인스턴스를 여러 개 띄우거나, 한 애플리케이션 안에서 컨슈머 스레드 수를 늘리는 식
  • 순서 보장(통 안에서만)


컨슈머 그룹과 파티션의 관계 

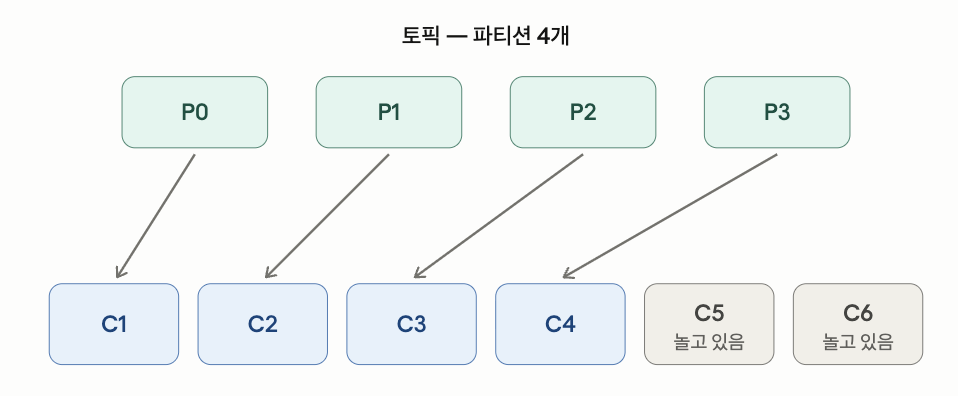
  • 한 컨슈머 그룹 안에서, 하나의 파티션은 정확히 하나의 컨슈머만 소비한다.
  • 반대로, 하나의 컨슈머는 여러 파티션을 동시에 소비할 수 있다.
  • 결론
    • 한 그룹의 최대 병렬 처리량은 파티션 개수로 제한된다.
    • 컨슈머를 파티션보다 많이 띄워도, 초과분은 그냥 논다.

  • 파티션이 4개면 아무리 컨슈머를 늘려도 동시에 4개까지만 일한다.
    • 처리량을 더 늘리려면 컨슈머가 아니라 파티션을 늘려야 한다.
  • 반대로 컨슈머가 파티션보다 적으면(컨슈머 2개) 한 컨슈머가 여러 파티션을 나눠 가진다.
    • 죽지는 않지만 그만큼 부하가 몰린다.
  • 다른 컨슈머 그룹은 같은 파티션을 독립적으로 또 읽는다.
    • 그룹마다 오프셋을 따로 관리하기 때문이다.
    • 토픽에 그룹/토픽/파티션 단위로 저장
    • "같은 메시지를 여러 시스템이 각자 소비"가 가능한 이유.


poll 루프와 리밸런싱

  • 컨슈머는 어떻게 "살아있다"고 인정받는가? (heartbeat.interval.ms vs session.timeout.ms vs max.poll.interval.ms)
  • poll()이 한 번에 가져온 배치를 처리하는 데 너무 오래 걸리면 무슨 일이 벌어지는가?
  • 그게 왜 리밸런싱 폭풍 → 컨슈머 증식 → 중복 처리로 번지는가?
  • AckMode.BATCH였던 게 왜 불에 기름을 부었는가?
내가 운영하는 구조는 완전한 MSA라기보다는, 모놀리식과 일부 분리된 서비스가 공존하는 하이브리드 구조에 가깝다.
display-api, order-api, ssr 등은 서비스 단위로 나뉘어 있지만, 데이터베이스나 레거시 도메인 의존성이 완전히 분리되어 있지는 않기 때문이다.


정리해보기 전에 우선 MSA가 뭔지 좀 생각해보자.

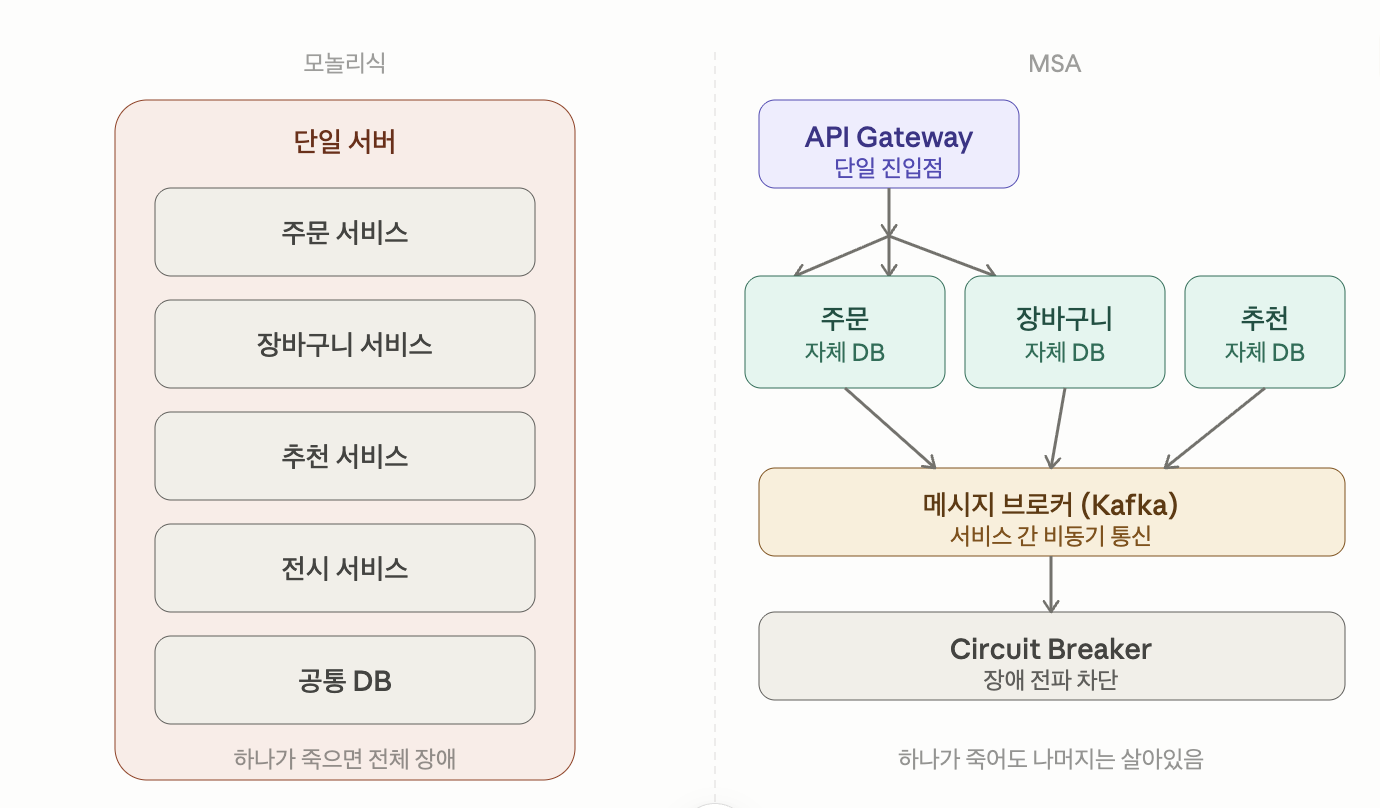
MSA의 핵심은?

  1. 서비스 독립성.
    • 각 서비스가 DB서버가 분리되어져있고, 독립적으로 배포됨
    • 모놀리식은 하나의 코드베이스에 모든 기능이 묶여 있어서 장바구니 버그 하나가 주문 전체를 죽이는 구조
  2. 서비스 간 통신
    • 직접 함수 호출 대신 Rest API(동기) 또는 Kafka 같은 메시지 브로거(비동기)로 통신
  3. 장애 격리
    • Circuit Breaker가 특정 서비스 장애가 전체로 번지지 않도록 차단.


현재 내 상황

  • DB 분리 여부?
    • MSA에서 제일 중요한 포인트 중 하나인 서비스별 DB 소유권이 없다
    • MSA라고 부르기 위해서는 단순히 API 서버가 여러 개로 나뉜 것만으로는 부족하고 각 서비스가 자신의 데이터를 직접 소유하고,다른 서비스의 DB를 참조하지 않아야 하지만 현재는 그런 상태가 아니다
  • 분산 모놀리식?
    • 내가 처한 상태와 비슷한 걸 서버는 여러 개로 나뉘었지만, 배포·DB·도메인 규칙·장애 영향도가 여전히 강하게 묶여 있다면 이것은 MSA라기보다 분산 모놀리식에 가깝다.


하지만 MSA를 한다고 무조건 좋을까?

  • 네트워크 호출 실패 가능성
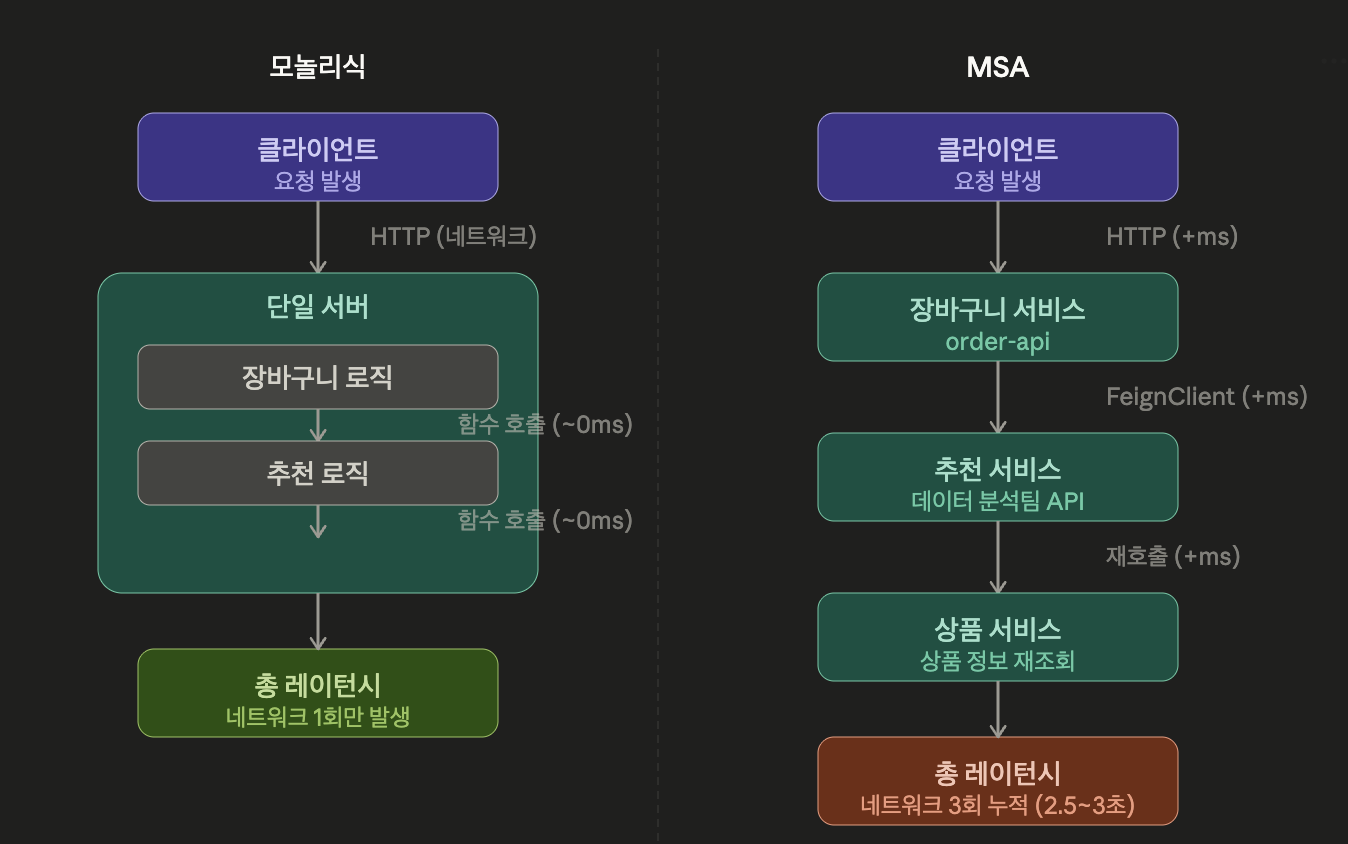
    • 모놀리식은 함수 호출이지만 MSA는 네트워크 호출이다.
    • 따라서, 나는 FeignClient로 추천 API를 호출할 때 Circuit Breaker를 걸었고, fallback을 빈 리스트로 처리하여 장애 및 실패 가능성에 대비한 구조로 개발했다
  • API 응답 지연
    • 네트워크 레이턴시가 추가된다.
    • 모놀리식은 서버 안에서 함수를 호출하기 때문에 레이턴시가 거의 0입니다. 하지만 MSA는 서비스 간 호출할 때마다 네트워크를 타고, 호출이 3번이면 레이턴시도 3번 누적된다.

  • 데이터 정합성 관리 어려움
    • 모놀리식은 주문 생성, 장바구니 비우기, 재고 차감을 하나의 트랜잭션으로 묶을 수 있는 구조이다.
    • MSA는 DB가 분리되면 묶고 싶어도 묶을 수 없는 구조입니다. DB가 서비스마다 다르니까 Spring @Transactional 이 아예 작동하지 않는다. 트랜잭션 자체가 DB 단위로 묶이기 때문입니다.
      • 해결방법 : saga패턴, outbox패턴
      • Saga 패턴은 각 서비스가 실패 시 보상 트랜잭션을 실행하는 방식
      • 아웃박스 패턴은 이벤트를 DB에 먼저 저장하고 Kafka로 발행해 원자성을 보장하는 방식
      • 면절 질문 : DB 분리하면 어떻게 정합성 보장할 건가요?
  • 로그 추적 어려움
    • 모놀리식 로그는 한 곳에 있지만, MSA는 서비스마다 로그가 흩어진다. 
  • 배포 단위는 나뉘었지만 장애 원인 파악은 더 어려워짐
    • 이건 앞의 로그 추적 어려움과 연결된다. 독립 배포가 가능해진 대신, 어느 서비스의 어느 배포가 문제를 일으켰는지 파악하는 복잡도가 올라간다
  • 운영 복잡도 증가
    • 서비스가 늘어날수록 모니터링, 배포 파이프라인, 인프라 관리 비용이 급격히 올라간다.

완전한 MSA가 필요한 시점은?

  • 서비스 규모가 커져서 팀이 서로 방해가 될 때, DB를 공유하면 한 팀이 스키마를 바꿨을 때 다른 팀 서비스가 터진다.
  • 서비스별로 트래픽 차이가 극단적일 때, 쿠팡이츠로 예를 들면 주문 서비스는 점심/저녁 피크에 폭발적으로 트래픽이 몰리지만, 정산 서비스는 하루 한 번 돌아도 된다. DB까지 분리해야 주문 서비스만 독립적으로 스케일 아웃이 가능하다.


우리 조직?

우리 조직에서는 DB까지 분리하기에는 비합리적이다. 팀이 1개밖에 없고, 파트도 업무도 분리되어져 있지 않고, MAU도 너무 낮다. 너무 복잡도가 높아질 확률이 높다. 그래서 우리는 DB를 공유하는 논리적 MSA단계였던 것 같다. 팀 규모와 서비스 성숙도를 고려했을 때 당시에는 합리적인 선택이었고, DB 분리는 서비스가 더 성장하고 팀 간 의존성이 문제가 되는 시점에 Saga 패턴과 함께 가져가야 할 다음 과제로 인식하고 있다.

배치 관련 경험은 꽤 있다고 생각했다. 장애가 발생하면 로그를 보고, 매일 배치 로그가 정상인지 확인했으니까..

그런데 면접에서 배치 서버가 어떻게 되어있냐고 물어보자 생각보다 답하지 못했던 질문들이 많았다.


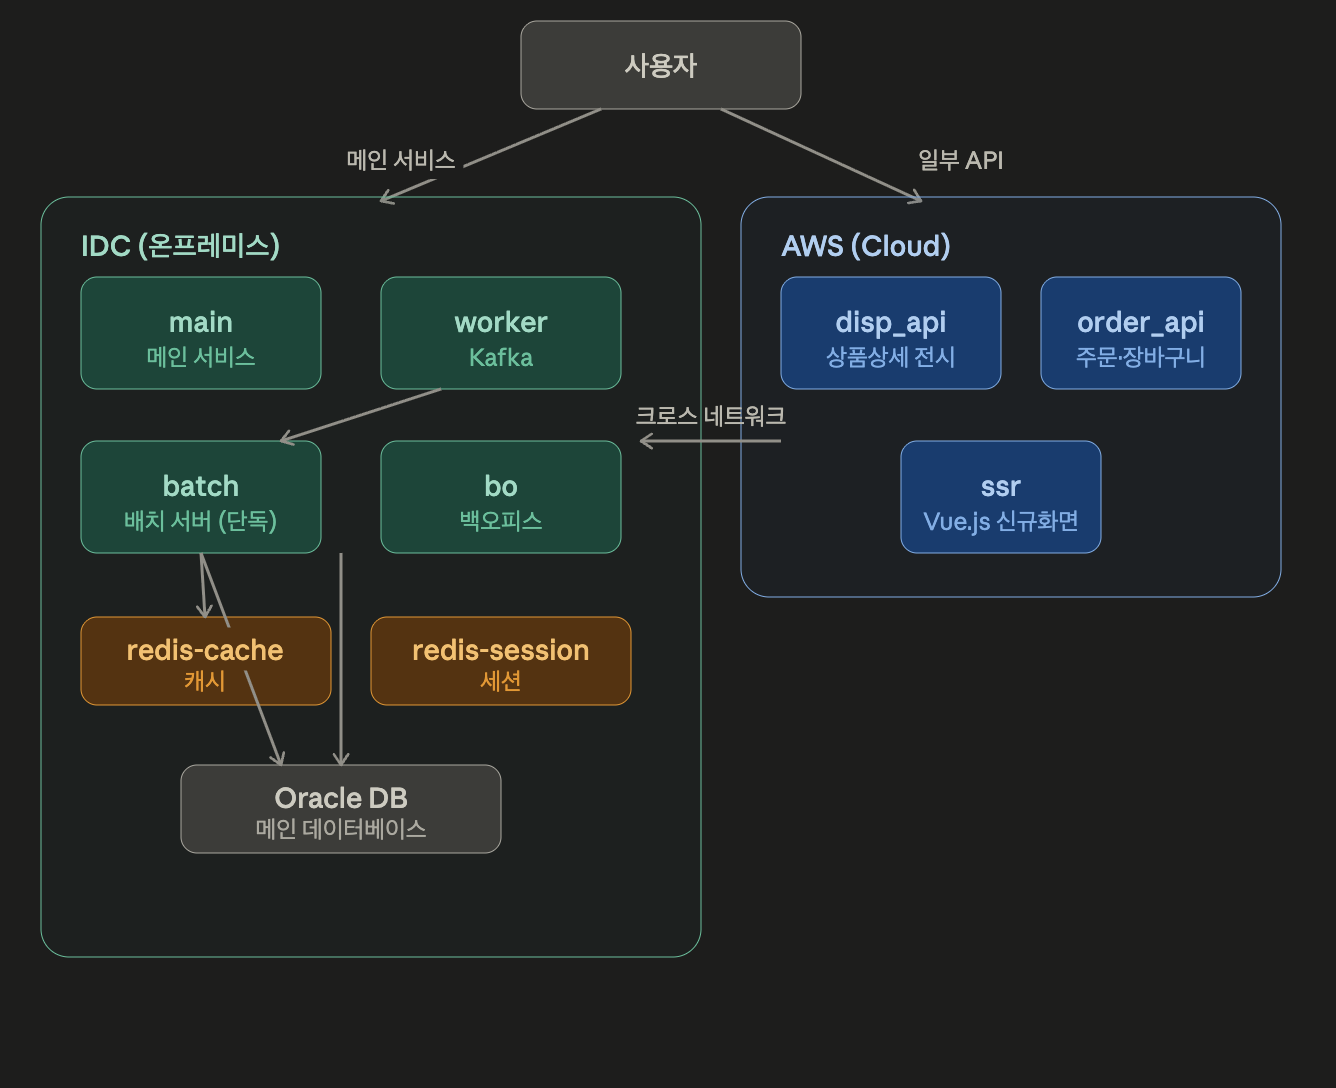
들어가기 전, 나의 인프라 토폴로지

  • 인프라 토폴로지 = 시스템들이 어떻게 연결되어 있는지 그 전체 지도

[CLOUD - AWS]
- display_api    → 상품상세 등 전시 API
- order_api   → 주문서, 장바구니 API  
- ssr         → Vue.js 신규 화면

[IDC - 온프레미스]
- batch       → 배치 서버 (단독)
- bo          → 백오피스
- main        → 메인 서비스
- work   → kafka 서버 (배치와 같은 서버)
- redis-cache → 캐시
- redis-session → 세션


1. 배치 서버는 어디서 돌아가고 있는가?

생각해보니 나는 배치를 운영하고 있었지만 인프라 토폴로지를 제대로 설명해본 적이 없었다.

현재 시스템은 AWS Cloud와 IDC(On-premise)가 공존하는 과도기 구조.

Cloud 영역에는 전시 API(display_api), 주문 API(order_api), Vue 기반 SSR 서버가 존재한다.

반면 IDC에는 batch, bo, main, Kafka(work), Redis(Cache/Session)가 운영되고 있다.

  • 배치서버
    • 온프레미스
    • 단독 서버로 애플리케이션 서버와 공유하지 않음
  • 실행방식
    • 배치 트리거는 Spring의 ThreadPoolTaskScheduler를 직접 구현한 커스텀 스케쥴러를 사용
    • 따라서, Cron Trigger, Fixed Delay, Fixed Rate 3가지 방식을 배포 없이 BO에서 스케쥴 방식과 실행 시간 변경 가능
    • BO에서 Bean 이름, 메서드명, Cron 표현식을 등록하면 서버 기동 시 스케줄이 자동으로 로드되어 실행됩니다. 수동 실행도 BO에서 HTTP 호출로 가능

2. 배치는 어떻게 실행되는가?

우리 시스템은 Quartz가 아니라 Spring ThreadPoolTaskScheduler 기반의 커스텀 스케줄러를 사용한다.

운영자는 BO에서 Bean 이름, Method 이름, Cron 표현식을 등록할 수 있다.

서버가 기동되면 DB에 저장된 스케줄 목록을 읽어 자동 등록한다.

또한 Cron, Fixed Delay, Fixed Rate 방식을 운영 중에도 변경할 수 있으며 별도 배포가 필요 없다.

ThreadPoolTaskScheduler를 사용하기 때문에 여러 배치가 동시에 실행될 수 있다.

ThreadPoolTaskScheduler

  • 배치 A 실행 중, 배치 B 동시 실행 중, 배치 C 동시 실행 중
  • 직원이 여러명인 회사라고 볼 수 있음
  • 배치가 겹쳐도 밀리지 않음.
  • 쓰레드를 여러 개 운영중

3. 배치가 정말 다른 배치에 영향을 주지 않을까?

처음에는 A 배치 실패 → B 배치 영향 없음이라고 생각했다.

하지만 실제로는 그렇지 않았다.

배치는 독립적으로 실행되더라도 데이터는 공유한다.

예를 들어 A 배치가 상태값을 READY → SEND 로 변경하던 중 실패한다면 READY 데이터가 남을 수 있다.

이 경우 다음 배치가 다시 데이터를 읽어 중복 처리할 가능성이 생긴다.

결국 중요한 것은 스케줄러가 아니라 데이터의 상태 전이와 멱등성 보장 방식이었다.

배치 간 의존성과 영향도

  • ThreadPoolTaskScheduler기반이기 때문에 배치 간 독립적으로 실행
  • A 배치 실패 -> B 배치 영향 X
  • 예외 케이스
    • DB를 공유하는 경우!
      • A배치가 B테이블 쓰다가 실패
      • 다음 배치 실행 시 READY가 남아있음
      • 중복 처리 가능성

4. 배포 중 실행 중인 배치는 어떻게 될까?

예전에는 배포하면 실행 중인 배치가 중단되는 줄 알았다.

실제로 배포 스크립트를 확인해보니 그렇지 않았다.

배포 과정에서 먼저 ShutdownSigTerm API를 호출한다.

배치 서버는 현재 실행 중인 작업이 모두 끝날 때까지 대기한다.

작업 완료 후에만 WAS를 종료한다.

즉 실행 중인 배치가 강제로 중단되지 않는다.

또한 batch-01, batch-02 두 대를 순차적으로 배포하는 롤링 배포 구조를 사용하고 있어 배포 중에도 항상 한 대는 운영 상태를 유지한다.


장애 시나리오 추론

  • 서버 재시작되면 스케줄이 초기화되고 DB에서 다시 로드되는 구조
    • 서버 재기동 시 실행 중이던 스케줄 상태를 초기화하고, DB에 등록된 사용 중인 배치 목록을 다시 로드해 자동으로 재등록함.
    • 배포 후 별도 작업 없이도 스케줄이 자동으로 살아남.
  • 배포 중 실행 중이던 배치는 어떻게 되는지
    • .gitlab/prd/.prd-batch.yml 파일에서 확인해본 결과,
      • batch_health_check -> 실행 중인 배치 완료 대기
      • WAS Stop
      • WAS Start
      • 크게 빌드 -> 스크립트 배포 -> WAS 배포(2단계) -> 완료 알림 흐름
      • 대상 서버는 batch-01, batch-02 두 대, 순차 처리 로직
    • 네트워크나 장애가 발생했을때는?
      • 이미지 배치의 경우 READY → SEND → SUCCESS/FAILED 상태 전이 모델로 멱등성을 보장했습니다. 반면 기존 일반 배치들은 주기적으로 실행되는 구조상, 장애 발생 시 해당 실행분은 누락되더라도 다음 스케줄 실행 시 정상 처리되도록 설계하였습니다. 다만 데이터 정합성이 중요한 배치의 경우 상태 전이 모델 적용이 필요하다고 판단하고 있습니다.

잡 구성(위에서 아래 순서)

    • 10:build:batch:prd
      • 배치 WAR 빌드 단계 (.prd_gradle_build_helper 사용)
    • 20:deploy:batch:prd:script
      • 서버에 운영 스크립트(batch-script.tgz) 배포/압축해제
    • 40:deploy:batch:prd:auto
      • 실제 배포 시작용 게이트(메시지/흐름 연결 역할)
    • 44:deploy:batch:prd:was 0/1
      • WAS 재기동 없이 먼저 WAR/Exploded 배포 처리
    • 44:deploy:batch:prd:was 1/1
      • 배치 active 작업 확인 후 WAS stop/start 수행
    • 90:deploy:batch:send:done
      • 최종 Slack 성공 알림
    • 배포 시 서버를 즉시 내리지 않고, 먼저 ShutdownSigTerm API를 호출해 실행 중인 배치가 완료될 때까지 대기.
    • 완료 확인 후 WAS를 종료하기 때문에 배치가 중간에 강제 중단 X
    • batch-01과 batch-02를 순차적으로 배포하는 롤링 배포 구조, 배포 중에도 한 대는 항상 운영
    • 배치마다 실행 서버를 지정할 수 있어, 운영 중 배치 중단 리스크를 최소화할 수 있는 구조

클라우드 전환 진행 중인 구조를 직접 경험

  • 레거시(IDC) → 클라우드 마이그레이션 과도기 시스템에서 개발한 경험

Kafka가 IDC에 있고, order_api는 Cloud에 있음

  • 즉 Cloud(order_api) → IDC(Kafka) 로 메시지를 던지는 크로스 네트워크 구조
  • 이 연결이 끊기면 어떻게 되는지 설명할 수 있으면 강점

Redis가 cache / session 분리


마무리

면접을 준비하면서 느낀 점은 배치를 운영한다는 것과 배치를 이해한다는 것은 다르다는 것이다.

예전에는 "배치가 성공했는지"만 확인했다.

지금은 다음 질문에 답할 수 있어야 한다고 생각한다.

  • 배치는 어디서 실행되는가?
  • 장애가 발생하면 어떤 시스템이 영향을 받는가?
  • 배포 중 실행 중인 배치는 어떻게 처리되는가?
  • 네트워크가 끊기면 어떤 문제가 발생하는가?
  • 데이터 중복은 어떻게 방지하는가?


커버링 인덱스는 논클러스터드 인덱스의 특징인 Random I/O를 없애버리는 기법이라, 한번 봐두면 좋다!

-> 논클러스더트 인덱스 내용 참조

https://nu-stock.tistory.com/29


[DB] 클러스터드 인덱스 vs 논클러스터드 인덱스, Oracle에는 왜 없을까?

면접 준비하자! 하면 DB 내용 중에 많이 나오는 것 중 하나인 클러스터드 인덱스와 논클러스터드 인덱스!근데 왜 알아야 하냐면 대부분의 테크기업에는 Mysql이나 PostgreSQL을 사용하기 때문에 oracle

nu-stock.tistory.com


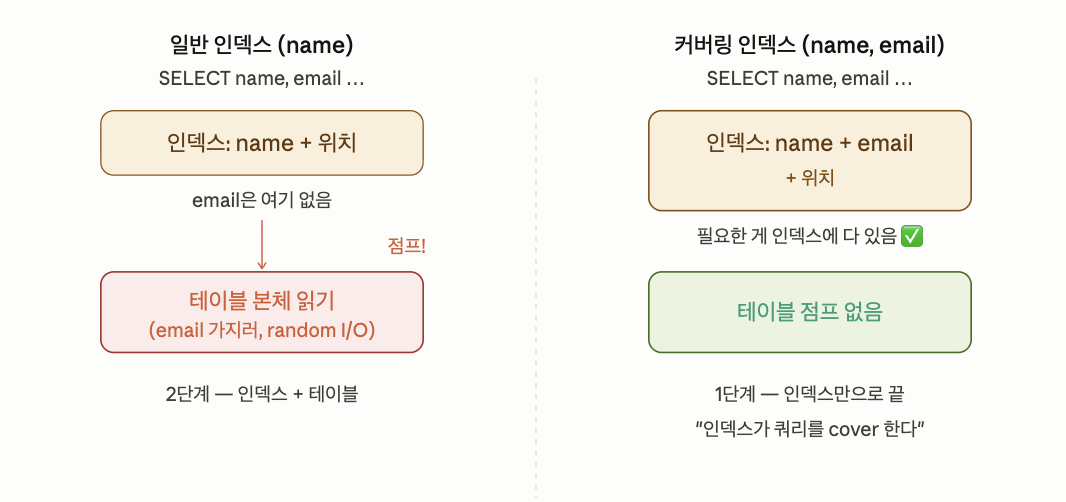
아래와 같은 쿼리를 돌린다고 가정해보자.

SELECT name, email FROM members WHERE name = '김철수'


  1. 이름 인덱스(B+tree)를 타고 내려가 '김철수' 위치를 찾음
  2. 근데 email은 인덱스에 없으니 그 위치로 점프해서 테이블 본체를 읽어 email을 가져옴 (점프가 random I/O)

이 2번 점프를 Oracle에서는 테이블 액세스(table access by index rowid)라고 함

인덱스에 없는 컬럼을 가지러 테이블 본체까지 갔다 옴

커버링 인덱스는 이 점프를 아예 없애준다.


커버링 인덱스

  • 그 쿼리가 필요로 하는 컬러을 인덱스 안에 전부 담아둬서, 테이블 본체를 안 봐도 인덱스만으로 답이 끝나는 인덱스
  • 이름의 직관 = 인덱스가 그 쿼리를 덮는다(= cover)
  • 인덱스에 (name, email)을 같이 인덱스에 넣는다면 테이블로 점프할 일이 없음
  • 조회 건수가 많을 수록 점프 1000번이 0번이 되니까 효과가 큼
  • 테이블 액세스를 제거한다는 큰 장점!!

트레이드 오프

  • 인덱스가 뚱뚱~
    • 굳이 name만 있으면 되는데, email까지 넣어서 인덱스 크기가 커짐
    • 욕심내서 컬럼을 5개, 10개 넣으면 인덱스가 거의 테이블만큼 커져서, 인덱스를 읽는 것 자체가 느려짐.
    • 저장공간, 메모리도 더 먹음
  • 쓰기가 더 어려워짐
    • email이 바뀌면 테이블뿐 아니라 인덱스도 같이 갱신 (인덱스의 일반적인 trade-off)

핵심 판단?

  • 자주 같이 조회되는 소수의 컬럼일 때만 커버링으로 묶기
  • DB별 차이
    • Oracle
      • 그냥 인덱스에 컬럼을 다 포함시키면 옵티마이저가 알아서 테이블 액세스를 생략
      • 실행계획에 테이블 액세스 단계가 사라지는 걸로 확인하면 됨!
    • MySQL InnoDB
      • 똑같이 동작하는데, 실행계획에서 Using index 라고 뜨면 커버링이 적용됐다~

면접 준비하자! 하면 DB 내용 중에 많이 나오는 것 중 하나인 클러스터드 인덱스와 논클러스터드 인덱스!

근데 왜 알아야 하냐면 대부분의 테크기업에는 Mysql이나 PostgreSQL을 사용하기 때문에 oracle만 사용했던 나같은 사람들도 좀 기억을 해두는 게 좋을 것 같다!


Oracle을 쓰면 만날 일이 없다는 이녀석 개념은 알아두자


클러스터드 vs 논클러스터드

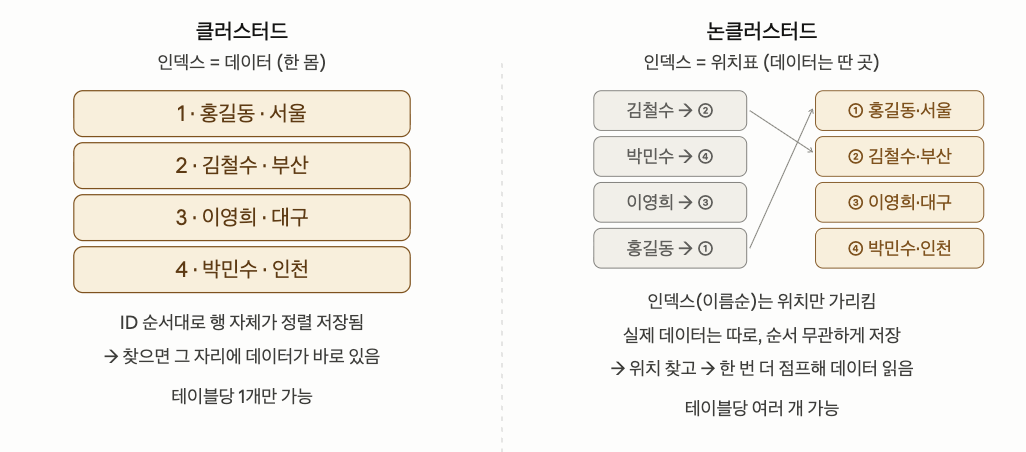
  • 핵심 질문 : 인덱스 순서대로, 실제 데이터(테이블 행)도 그 순서로 디스크에 줄 세워 저장하느냐?
    • YES : 클러스터드
    • NO : 논클러스터드


클러스터드 인덱스

  • 인덱스 순서 = 데이터 저장 순서
  • ID로 클러스터드 인덱스를 만들면, 테이블 행 자체가 ID 1,2,3,4.. 순서로 디스크에 줄세워 저장됨.
    • 인덱스가 곧 데이터
    • ID로 찾아 내려가면 그 리프 자리에 데이터가 바로 있음 (한번에 끝)
  • 장점
    • 찾으면 데이터가 거기 있으니 추가 점프 X
    • 특히 범위 검색 (ID 100 ~ 200)이 빠름
    • sequential I/O로 쭉 읽으면 됨
  • 한계
    • 데이터를 물리적으로 한 줄로 세우는 거라 기준은 하나뿐!
    • 테이블당 클러스터드 인덱스는 딱 1개
      • ex) 데이터를 날짜순으로 인쇄하면 가격순으로는 인쇄할 수 없는거랑 같음

논클러스터드 인덱스

  • 인덱스는 데이터의 위치(주소)만 들고 있고, 실제 데이터는 다른 곳에 저장
  • 이름순으로 논클러스터드 인덱스를 만들면, 인덱스엔 "김철수 -> 2번 위치"식으로 주소만 있고, 행을 읽으려면 주소로 한 번 더 점프
  • 장점
    • 데이터 본체랑 분리돼 있으니 여러개 만들 수 있음
    • 이름순, 가격순, 날짜순 인덱스를 동시에 둘 수 있음
  • 한계
    • 인덱스에서 위치 찾고 -> 데이터로 점프하는 2단계라 클러스터드보다 한번 더 일함
    • random I/O


Oracle 개발자는 몰라?

  • Oracle 
    • 기본 테이블이 Heap 테이블 : 데이터를 그냥 빈자리에 넣음 (정렬 x)
    • 모든 인덱스는 사실상 논클러스터드처럼 동작
    • 데이터를 인덱스 순으로 정렬 저장하고 싶으면 "IOT(Index-Organized Table)"라는 걸 따로 만들어야 함
      • Oracle식 클러스터드 인덱스
  • MySQL(InnoDB)
    • 무조건 클러스터드가 강제
    • PK가 자동으로 클러스터드 인덱스가 되고, 데이터가 PK 순서로 정렬 저장됨
    • 그래서 InnoDB에선 PK 설계가 성능에 직접 영향을 줌


면접대비

  • 클러스터드는 인덱스 순서대로 데이터 자체를 정렬 저장해서 인덱스가 곧 데이터인 방식이고, 테이블당 하나만 가능합니다. 논클러스터드는 위치만 가리켜서 여러 개 만들 수 있고요. 다만 이건 SQL Server/MySQL 용어이고, 제가 쓰던 Oracle은 기본이 힙 테이블이라 이 개념이 없고, 대신 IOT가 클러스터드에 해당합니다. MySQL InnoDB는 반대로 PK가 항상 클러스터드입니다

프론트에서 CORS 에러가 나니까, 이건 백엔드가 아니고 프론트엔드 문제라고 나는 생각해왔기 때문에 깊게 살펴보지도 공부하지도 않았었다. 근데 백엔드 면접에서 계속 나오더라.. 그러니 한번 봐보자.


CORS란?

  • Cross-Origin Resource Sharing
  • 보안 기능이 아니라 브라우저의 보안 정책을 "완화"하는 장치
  • 문제가 아니라 허용해주는 규약!!
  • 브라우저에는 원래 동일 출처 정책(Same-Origin Policy, SOP)이 있음.
    • 출처(Origin) = 프로토콜 + 호스트 + 포트, 세 가지가 모두 같아야 같은 출처
      • https://shop.com → https://api.shop.com : 호스트 다름 → 다른 출처
      • https://shop.com → http://shop.com : 프로토콜 다름 → 다른 출처
      • https://shop.com:443 → https://shop.com:8080 : 포트 다름 → 다른 출처
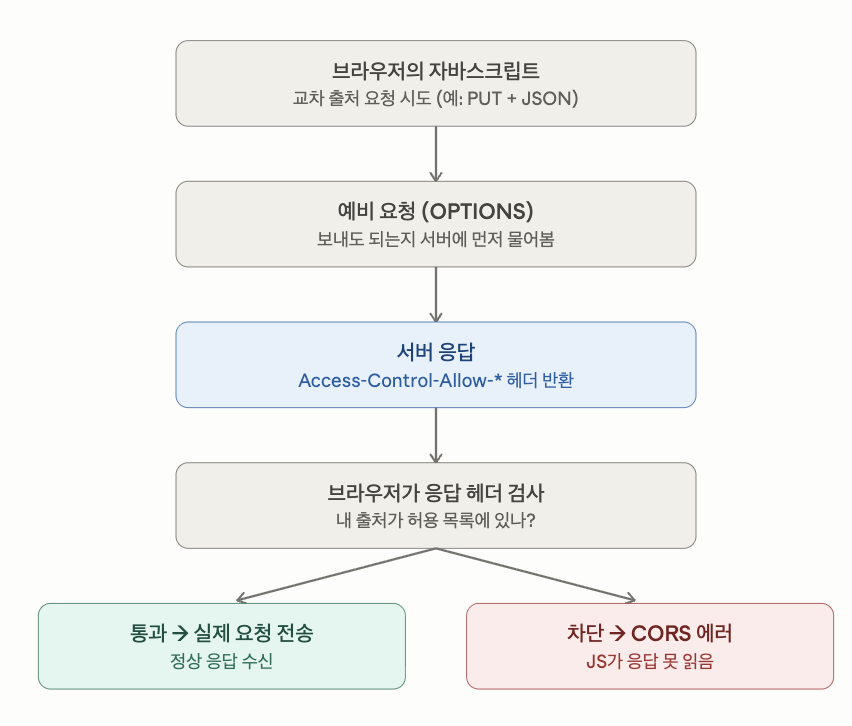
  • SOP는 "A 사이트에서 받은 스크립트가 B 사이트의 응답을 함부로 읽지 못하게" 막음
  • CORS는 거꾸로 "B 서버가 명시적으로 허락하면 A에서 읽어도 돼"라고 풀어주는 규약

왜 존재하는가?

  • 만약 SOP가 없다면, 사용자가 로그인된 상태로 악성 사이트에 접속했을 때 그 사이트의 자바스크립트가 사용자 쿠키를 실어서 bank.com/내계좌를 호출하고 응답 내용을 읽어가는 일이 가능
    • SOP가 이 응답을 읽는 행위를 막음
  • CORS 위반이어도 요청은 서버에 도달할 수 있음.
  • 브라우저는 "응답을 자바스크립트에게 넘겨주는 단계"에서 막을 뿐, 요청 전송 자체를 항상 막는 건 아님
  • CORS는 어디까지나 브라우저가 강제하는 클라이언트 측 정책

어떻게 대처하는가?

  • CORS에러는 서버가 허용 헤더를 안 내려줘서 생기는 거라, 해결도 보통 서버쪽에서 함.
  • 서버에서 응답 헤더 설정
    • Access-Control-Allow-Origin에 허용할 출처를 명시
    • Spring이라면 @CrossOrigin, 또는 전역으로 WebMvcConfigurer의 addCorsMappings, 시큐리티를 쓰면 CorsConfigurationSource로 설정
  • 인증 정보(쿠키)를 같이 보낼 때
    • ccess-Control-Allow-Credentials: true가 필요하고, 이때는 Allow-Origin에 *를 쓸 수 없음
    • 반드시 구체적인 출처를 명시해야 함. (보안상 와일드카드 + 쿠키 조합을 브라우저가 막아둠)
  • 프록시 우회
    • 개발 환경에선 같은 출처처럼 보이게 하는 프록시(Vite/webgpack dev server proxy, nginx 리버스 프록시)로 푸는 경우도 많음
    • 출처를 같게 만들어 SOP 자체를 안 건드리는 방식


면접대비

  • 매번 OPTIONS 요청이 추가로 나가면 비효율 아닌가요?
    • 맞습니다. 그래서 Access-Control-Max-Age로 예비 요청 결과를 캐싱해 일정 시간 동안 재요청을 생략합니다. 트레이드오프는 캐시시간과 정책 변경 반영 지연이 생길 수 있으므로 상황에 맞춰서 변경할 수 있을 것이라 생각합니다.
app:
  cors:
    # 허용할 프론트 출처(콤마 구분). 예: http://localhost:3000,http://localhost:5173
    allowed-origins: http://localhost:3000


Config를 Spring이 부르는 방법

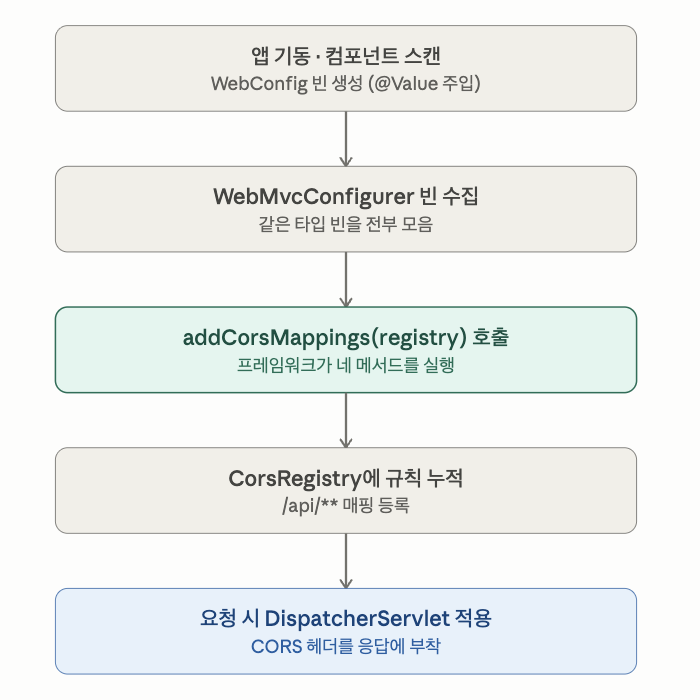
  • addCorsMappings를 부르는 게 아니라, 스프링이 대신 불러줌 = 제어의 역전(IoC)
    1. @Configuration이 붙어 있으니 앱이 뜰 때 컴포넌트 스캔이 이 클래스를 발견하고 빈으로 등록
    2. 빈을 만들려면 생성자를 호출
    3. 생성자에 @Value가 있으니 이 시점에 yml 값이 allowedOrigins로 주입
    4. 이 클래스가 WebMvcconfigurer를 구현
    5. 스프링 MVC 설정부(DelegatiogWebMvcConfiguration 쪽)는 컨테이너에 "WebMvcConfigurer"타입 빈 전부 다 줘"라고 요청해서 리스트로 모음
      • DelegatiogWebMvcConfiguration : 위임(delegation)하는 중계자 역할
    6. MVC를 세팅하는 과정에서 모아둔 configurer들을 하나씩 돌면서 addCorsMappings(registry)를 직접 호출
    7. 이때 registry도 스프링이 만들어서 인자로 넘겨줌
    8. 따라서 코드 어디에도 호출문이 없는 게 정상! (호출하는 주체가 코드가 아니라 프레임워크)
/**
 * 전역 CORS 설정.
 *
 * 프론트(gb-web, http://localhost:3000)가 브라우저에서 직접 백엔드를 호출할 수 있도록 허용한다.
 * 허용 출처는 application.yml 의 `app.cors.allowed-origins` 로 외부화(콤마 구분, 기본값 localhost:3000).
 *
 * 현재 프론트는 쿠키/세션 인증을 사용하지 않으므로 allowCredentials 는 켜지 않는다.
 */
@Configuration
class WebConfig(
    @Value("\${app.cors.allowed-origins:http://localhost:3000}")
    private val allowedOrigins: Array<String>,
) : WebMvcConfigurer {

    override fun addCorsMappings(registry: CorsRegistry) {
        registry.addMapping("/api/**")
            .allowedOrigins(*allowedOrigins)
            .allowedMethods("GET", "POST", "PUT", "PATCH", "DELETE", "OPTIONS")
            .allowedHeaders("*")
            .maxAge(3600)
    }
}


DDD가 대체 뭘까..?


DDD

  • 소프트웨어를 기술이 아니라 업무(도메인) 중심으로 모델링하자.
  • 그 서비스가 다루는 실제 업무가 설계를 이끌게 하자.
  • 코드가 DB 구조가 아니라 비즈니스가 생각하는 방식을 닮아야 한다는 철학
  • 기둥1
    • 유비쿼터스 언어(공용어)
      • 개발자, 기획자/도메인 전문가가 같은 단어를 쓰고, 그 단어가 코드에 그대로 나타나야 함.
      • 장바구니에 담는다 -> cart.addItem() O, cartService.insertCartRow() X
      • 기획이 원하는 것과 코드가 원하는 것 사이의 번역 오류가 줄어드는 것
  • 기둥2
    • 풍부한 도메인 모델
      • DDD는 규칙(행위)이 데이터와 같은 객체 안에 살아야 함.
// 풍부한 모델 (DDD가 지향) — 규칙이 객체 안에
class Cart {
    private List<Item> items;
    void addItem(Item item) {
        if (item.isRefrigerated() && refrigeratedCount() >= 5)
            throw new CartRuleException("냉장 상품은 5개까지 담을 수 있습니다");
        items.add(item);
    }
}
  • DDD의 진짜 핵심은 패턴 암기가 아니라 "업무를 대화로 이해해서 모델로 옮기는 규율"
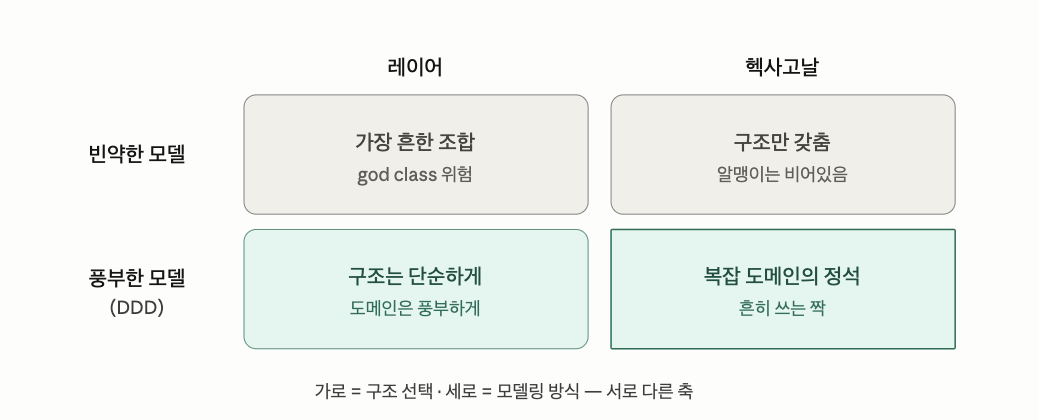
    • 헥사고날은 도메인을 깨끗하게 격리하는 '그릇·구조'를 주고, DDD는 그 깨끗한 도메인 안을 '업무를 닮은 풍부한 모델'로 채우는 방법
    • 레이어 vs 헥사고날 그리고 DDD


나는 여태까지 DDD에 나오는 도메인이 곧 DTO를 나타내는 것이라고 생각했는데, 뭔가 잘못된 생각이라는 걸 이제야 깨닫게 됐다.

  • DDD는 객체지향의 원래 정신
  • OOP는 원래 "데이터와 그 데이터를 다루는 행위를 한 객체에 같이 두자"였는데, 우리가 습관적으로 데이터(Entity)와 행위(Service)를 갈라놨던 것.
  • 그러니까 빈약한 모델이 오히려 객체지향을 절차지향처럼 쓴 거고, 풍부한 모델/DDD는 그걸 제자리로 돌려놓는 것.
  • "DTO에 로직 넣는 이상한 짓"이 아니라 "객체에 원래 있어야 할 걸 돌려준 것"
// ① 진짜 DTO — 웹에서 들어온 데이터 운반만. 규칙 없음
class AddItemRequest {
    Long productId;
    int quantity;          // getter/setter만
}

// ② 도메인 객체(엔티티) — 데이터 + '자기 규칙'을 가짐. DTO 아님
class Cart {
    private List<Item> items;
    void addItem(Item item) {                 // 카트 하나로 판단되는 규칙
        if (item.isRefrigerated() && refrigeratedCount() >= 5)
            throw new CartRuleException("냉장 상품은 5개까지");
        items.add(item);
    }
}

// ③ Service — '규칙'이 아니라 '조율'을 함
class CartService {
    void addItem(Long cartId, AddItemRequest req) {
        Cart cart = cartStore.findById(cartId);   // ㉠ DB에서 꺼내고 (바깥일)
        Item item = itemFactory.from(req);
        cart.addItem(item);                        // ㉡ 규칙은 Cart에게 맡김
        cartStore.save(cart);                      // ㉢ 다시 저장 (바깥일)
    }
}


DDD 적용해봤나요?

  • 객체에 validation 메서드를 두긴 했지만, setter가 열려 있어 상태를 외부에서 바꿀 수 있었고 검증을 따로 호출하는 방식이었습니다. 그래서 객체가 스스로 불변식을 지키는 풍부한 도메인 모델까지는 아니었고, 입력 검증을 객체에 모아둔 정도였다고 생각합니다.

신입때, 그리고 주니어때는 아키텍처에 대해서 물어보지 않았던 것 같은데, 준시니어가 되면서 조금씩 아키텍처를 물어보는 듯한 질문들이 많아졌다..

그리고 내 대답 "시니어가 추천해줘서.."

"너 탈락"

이제 탈락하지 않아야겠다는 의지로.. 아키텍처 체크 한번 해보자..


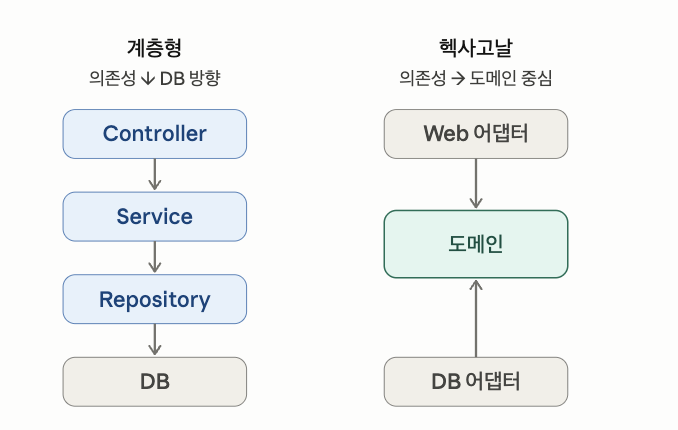
계층형 (Layered / 3-tier)

  • Controller → Service → Repository → DB
  • 핵심 아이디어 : 기술적 관심사로 나눈다
    • 화면/비즈니스/데이터 접근을 층으로 분리
  • 실무에서는 Service 계층에 비즈니스 규칙과 영속성 로직이 함께 모이는 경우가 쉬움
  • 규모가 커질수록 Service가 비대해지고, 도메인 모델은 단순 데이터 컨테이너로 전락하기 쉬움
  • 의존성 방향
    • 계층형은 의존성이 위에서 아래로, 즉 DB쪽으로 향함.
    • Service가 Repository를 알고, Repository가 JPA/DB를 안다.
    • 결국 비즈니스 로직이 영속성 기술에 묶임
  • 장점 : 단순하고 직관적이고, 모든 개발자가 알고, Spring 기본 구조와 일치해서 시작이 빠름
  • 단점
    • (트레이드오프) 도메인 로직이 갈 곳이 없어서 전부 Service로 몰림
    • 도메인 객체는 getter/setter만 있는 빈약한 도메인 모델이 되기 쉬움.
    • 비즈니스 규칙을 테스트하려면 DB/JPA를 같이 띄워야 해서 순수 단위 테스트 어려움
    • 규모가 커지면 Service가 god class가 됨

헥사고날 (Ports & Adapters)

  • 이번에 처음으로 계층 아키텍처에서 헥사고날 아키텍처를 사용해보면서 정확한 비교가 필요하다고 생각했다.
  • 헥사고날은 DDD를 구현할 때 자주 사용되는 아키텍처 중 하나
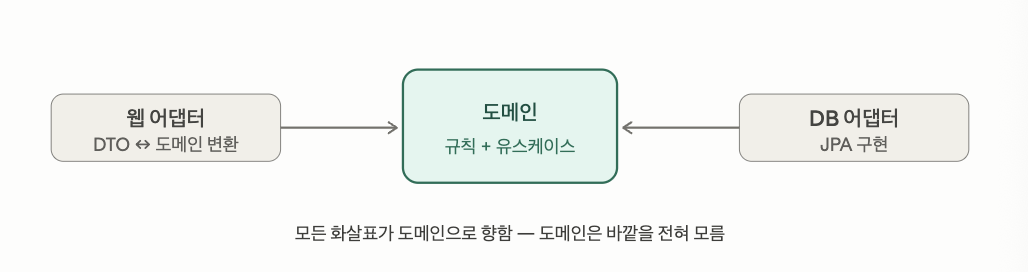
  • 계층형과 정반대로, 모든 의존성이 도메인(중심)쪽으로 향함 = 모든 소스 코드 의존성이 도메인 또는 애플리케이션 계층을 향하도록 설계
  • 도메인이 포트(인터페이스)를 정의
  • 바깥의 어댑터(JPA, Rest, Kafka)가 그 포트를 구현
    • 도메인은 JPA가 뭔지, Kafka가 뭔지 모름.
    • 이게 의존성 역전(DIP)의 실제 적용
  • 인바운드 어댑터(Controller, 메시지 리스너) -> 유스케이스 포트를 호출
  • 아웃바운드 어댑터(JPA 레포지토리, 외부 API 클라이언트) -> 도메인이 정의한 포트를 구현
  • 인터페이스로 화살표를 뒤집는 작업이, 이 "묶임"을 푸는 행위
  • 규칙을 JPA 표식 없는 순수한 객체로 떼어내면, 규칙은 더 이상 영속성 기술에 묶이지 않음
  • 장점 : 도메인이 인프라 없이 순수하게 테스트되고, DB나 메시징을 갈아끼우기 쉽고, 경계가 명시적, 복잡하고 오래 갈 시스템에 강함
  • 단점
    • 보일러플레이트가 많아짐
    • 인터페이스가 늘어남
    • 도메인 객체 <-> JPA 엔티티 <-> DTO 매핑 비용이 늘어남
    • 단순 CRUD에 적용하면 과설계


아키텍처란?

  • 무엇이 무엇에 의존하게 둘 것인가?
  • 어떤 시스템이든 두 종류의 코드가 섞여 있다.
    • 잘 안 바뀌고 진짜 중요한 것 - 비즈니스 규칙
      • ex) 주문 금액이 3만원 이상이면 무료배송
    • 자주 바뀌고 사실 부수적인 것 - 도구
      • DB가 MySQL이냐 Mongo냐
      • JPA를 쓰냐 MyBatis를 쓰냐
      • 화면이 웹이냐 앱이냐 등
    • 좋은 아키텍처의 목표
      • 중요한 것(규칙)이 부수적인 것(도구)에 의존하지 않게 만드는 것.
      • 계층형 : Service가 규칙을 들고 있는데, 그 Service가 Repository(=JPA, DB)에 의존
        • 즉, 중요한 규칙이 부수적인 도구 쪽을 바라봄
        • DB나 ORM을 바꾸면 규칙 코드까지 건드려야 함.
        • 규칙만 테스트하고 싶어도 DB를 띄워야 함.
      • 헥사고날은 이 화살표를 뒤집은 것!
        • 규칙(도메인)을 한 가운데 두고, DB/web/외부API는 전부 바깥에서 정의한 인터페이스에 맞추게 함.
        • 규칙은 JPA가 뭔지도 모름

의존성을 어떻게 배치하냐

  • OrderService(=중요한 규칙) -> OrderRepository(=DB/JPA에 묶인 도구)
  • 화살표는 항상 필요로 하는 쪽에서 필요한 쪽으로 감
  • 화살표가 있다는 것은 뒤엣것이 바뀌면 앞엣것이 영향을 받음
  • A가 B를 알고/쓰고/필요로 한다 = A가 B에 의존한다


계층 -> 헥사고날로 가는 이유

  • 영속성 기술에 묶인다
    • 중요한 규칙 코드가 DB 저장 기술에 의존해버려서, 저장 기술이 바뀔 때마다 규칙까지 같이 흔들리는 상태
  • 기술에 묶이지 않기 위해서 헥사고날로 가는중!
  • "매핑 비용이라는 대가를 알면서도, 도메인 복잡도가 그 대가를 정당화했기 때문에 선택했다"
    • 매핑 : 한 모양을 다른 모양으로 바꿔주는 작업
      • 도메인 객체를 순수하게 둬도 결국 @Entity 도 필요
      • 결국 저장할때마다 Order -> OrderEntity, OrderEntity -> Order로 서로 바꿔주는 코드를 써야 함
      • 도메인 -> 엔티티, 엔티티 -> 도메인
    • 도메인이 단순하면(그냥 CRUD, 규칙이 거의 없음) → 보호할 알맹이가 없는데 매핑 비용만 내는 거라 낭비, 이럴 땐 헥사고날이 과설계.
    • 도메인이 복잡하면(장바구니처럼 추천 로직/배송 온도 조건/무료배송 판정이 얽힘) → 그 복잡한 규칙을 깨끗하고 테스트 가능하게 지켜내는 가치가 매핑 비용보다 큼, 그래서 비용을 내는 게 정당화


도메인은 뭘까?

  • 저는 처음에 도메인이 DTO를 말하는 것인가 싶었는데!? 아니었다
  • 도메인이라는 단어가 너무 추상적이라서 그렇게 된 것
  • 도메인 : 그 서비스가 다루는 업무 영역과 그 규칙 자체.
    • 주문이란 무엇인가? 무료배송은 언제 되는가? 장바구니엔 뭘 담을 수 있는가? - 비즈니스의 핵심
    • 코드로는 그 규칙을 품은 객체 (Order, Cart)랑 그 규칙을 실행하는 로직.
    • 모든 의존성은 도메인 쪽으로 향한다 라는 말은 웹 코드도, DB 코드도, 전부 도메인을 필요로 한다.(의존한다) 근데 도메인은 그 누구도 필요로 하지 않는다.


도메인이 인프라 없이 순수하게 테스트된다

  • 인프라(Infrastructure)는 비즈니스 규칙이 아니라 그 규칙이 돌아가게 받쳐주는 기술적 기반 설비
    • Oracle, AWS, Redis, Kafka
    • 만약 규칙이 인프라(JPA, DB)에 묶여 있으면, "3만원 이상 무료배송" 규칙 하나를 테스트하려고 해도 진짜 Oracle을 띄우고 연결해야 함.
    • 테스트가 느리고, 무겁고, DB가 잠깐 죽으면 규칙은 멀쩡한데 테스트 실패.
      • OrderService(규칙)는 OrderStore라는 약속에만 의존하니까, 진짜 JPA 대신 가짜를 꽂아도 똑같이 돌아감
      • Oracle도 Kafka도 안 띄우고, 순수하게 규칙만 검증할 수 있음

면접대비

  • 왜 헥사고날을 썼나요?
    • 가장 큰 이유는 복잡도 관리였습니다. 장바구니는 추천 상품 호출, 온도별 무료배송 판정, 같은 온도대 상품 추천, 가격·할인 계산 같은 규칙이 한 Service에 전부 몰려 있었습니다. 그 결과 Service가 너무 비대해져서, 기능 하나를 고치려 해도 코드를 분석하는 것 자체가 어려운 상태였습니다. 그래서 뒤엉킨 책임을 분리하고 핵심 규칙을 도메인으로 모으는 재구조화가 필요하다고 판단했고, 그 분리를 잡아주는 틀로 헥사고날을 적용했습니다.
    • 전체 아키텍처 방향은 팀에서 함께 잡았고, 장바구니 영역에 적용하고 설계하는 건 제가 주도했습니다.
  • 어떤 문제를 해결하려고 했나요?
    • 핵심 문제는 비즈니스 규칙과 데이터 접근이 한 Service에 뒤섞여 있다는 점이었습니다. 규칙이 여러 개 얽힌 데다 MyBatis 조회 호출까지 같은 흐름에 섞여 있어서, 어디까지가 규칙이고 어디부터가 조회 로직인지 구분이 안 됐습니다. 그래서 규칙을 도메인으로 끌어내 한곳에 모으고, 데이터 접근은 포트 뒤로 분리해 둘을 떼어놓는 것이 목표였습니다. 규칙과 인프라 호출이 섞여 코드를 이해하기 어렵다는 점이 가장 큰 문제였습니다.
  • 그 정도면 책임 분리만으로 됐던 거 아닌가요? 굳이 헥사고날까지?
    • 맞는 지적입니다. 가독성 개선의 핵심은 책임 분리였고, 헥사고날은 그 분리를 강제하고 경계를 명시적으로 두기 위한 틀이었습니다. 더 가볍게 갈 수도 있었지만, 장바구니가 계속 확장되는 영역이라 명시적 경계를 두는 쪽이 장기적으로 낫다고 판단했습니다.
  • 계층형으로는 안됐나요? (기존꺼로는 해결이 어려웠나요?)
    • 계층형으로도 동작은 충분히 했을 것이고, 사실 책임 분리 자체는 계층형 안에서도 할 수 있습니다. 제가 헥사고날을 택한 이유는 도메인이 인프라를 모르게 하는 경계를 더 분명히 두고 싶었기 때문입니다. 계층형에서는 Service가 데이터 접근을 직접 들고 있어 규칙과 인프라가 다시 섞이기 쉬운데, 포트와 어댑터로 나누면 그 혼재가 눈에 띄게 됩니다. 다만 저희는 한 모듈 안에서 패키지로 나눈 수준이라 컴파일 차원의 강제까지는 아니었고, 그 점은 한계로 인정합니다. 더 강하게 가려면 도메인을 별도 모듈로 분리하거나 ArchUnit으로 검증하는 방법이 있다고 보고 있습니다.
  • 회사 프로젝트 전체에 적용해야 하나요?
    • 전부 적용하는 것이 답이라고 생각하지는 않습니다. 헥사고날은 도메인 객체와 영속성 모델 사이의 매핑 비용 같은 대가가 있어서, 도메인이 단순한 영역에서는 오히려 과한 구조라고 봅니다. 단순 CRUD에 가까운 영역은 계층형이 더 빠르고 읽기도 쉽습니다. 그래서 규칙이 복잡하고 오래 확장될 핵심 영역에만 선택적으로 적용하고, 단순한 영역은 계층형으로 두는 것이 합리적이라고 생각합니다.

+ Recent posts