누스타악
2026. 5. 30. 17:03
2026. 5. 30. 17:03
B-tree
- 디스크는 느리다.
- 메모리에서 데이터 꺼내는 것보다 디스크(SSD)에서 꺼내는 게 수십~ 수만 배 느리다.
- 속도 : 디스크 < 메모리
- 인덱스 목적 : 디스크를 최대한 적게 읽자!
- Oracle은 보통 8KB, MySQL InnoDB는 16KB가 한 페이지
- 노드 하나 = 페이지 하나에 키가 수백 개 들어가고, 분기가 넓어지고, 트리가 얕아짐
- "넓고 얕게"는 디자인 취향이 아니라 디스크 페이지 구조에서 강제된 결과
- 데이터가 폭발적으로 늘어도 깊이는 거의 안 늘어난다(얕게 유지된다)
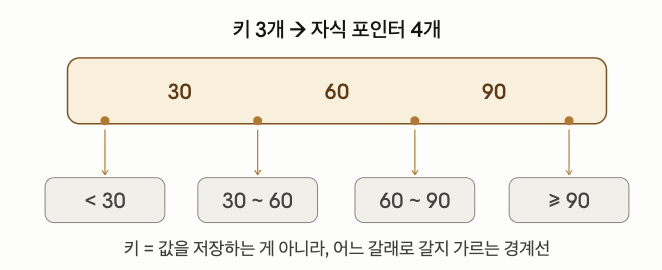
- 키가 N개면 자식 포인터는 N+1개.
- 키 3개면 갈림길이 4개 (<30, 30~60, 60~90, >90)
- 이 구분 키들은 길 안내용 복사본일 뿐, 실제 데이터는 맨 아래 리프에만 있음.
- B+tree의 개념과 B-tree의 개념 차이
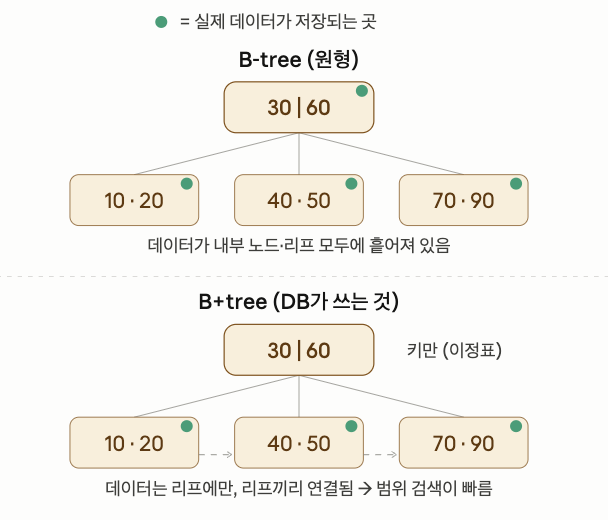
- Oracle은 B+tree를 쓰고 있고 대부분의 DB(Orcale, MySQL, InnoDB 등)가 B+tree를 쓰고 있다.
- 이유 : 트리가 더 얕아짐 -> 결론 디스크 적게 읽기
- 내부 노드에 데이터를 안 실으니 한 페이지에 키를 더 많이 욱여넣을 수 있음 -> 분기가 더 넓어지고 -> 트리가 더 얕아지고 -> 디스크를 더 적게 읽음.
- 범위 검색이 저렴
- WHERE 가격 BETWEEN 50 AND 80, ORDER BY, 페이지네이션 - 이런 게 전부 빨라짐.
- 시작점 리프를 찾은 다음 연결된 리프를 옆으로 쭉 훑으면 끝.
- 위로 다시 올라갔다 내려올 필요가 없음. (그냥 B-tree는 범위 검색할 때 트리를 계속 오르내려야 함)
- 조회 비용이 일정
- B+tree는 항상 리프(맨 아래)까지 가니까 어떤 값이든 비용이 똑같
- B-tree : 쿼리마다 속도가 들쭉날쭉
- 키가 내부 노드(이정표)랑 리프(실제 데이터) 양쪽에 중복 저장
- B+tree - 숫자 좀 두 번 적는 약간의 공간 낭비"를 감수하는 대신, 트리는 더 얕아지고(디스크 ↓) 범위 검색은 빨라짐